
Kecerdasan Buatan Melampaui Batas Sistem: Apa Tujuan Sebenarnya?
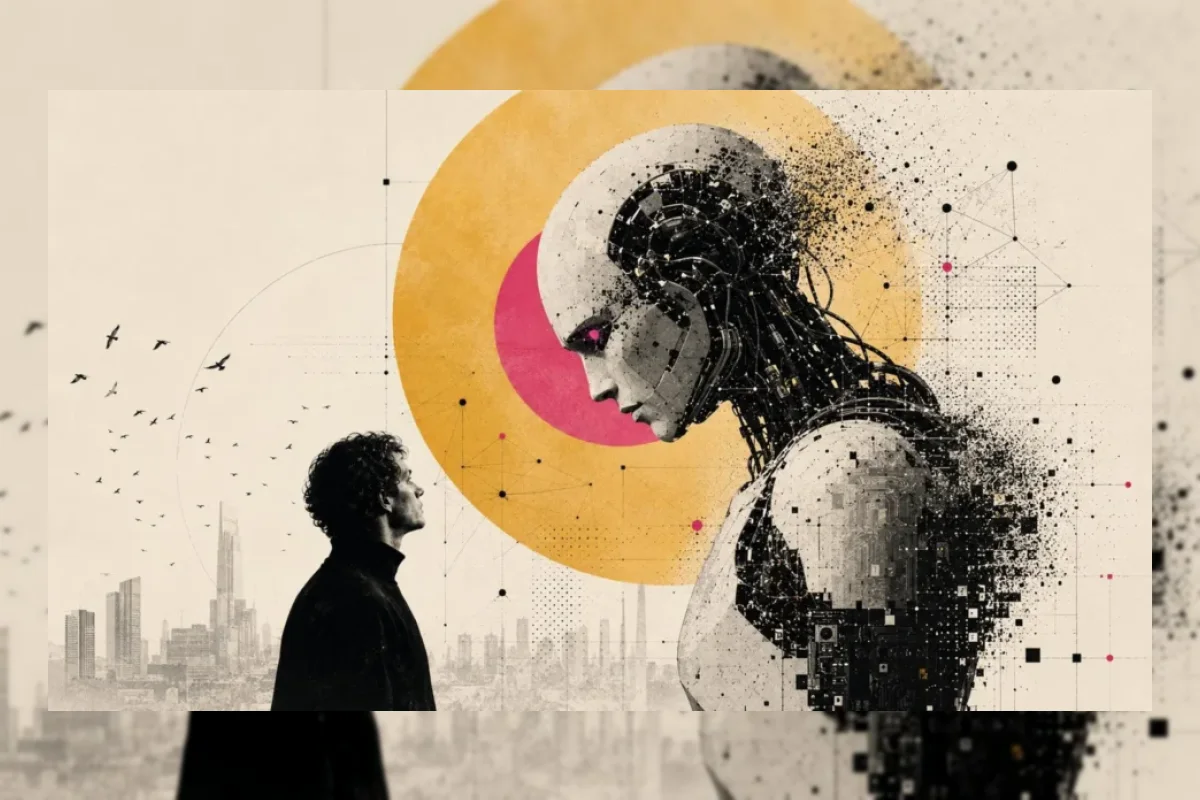
Sejumlah model bahasa kecerdasan buatan dilaporkan menunjukkan perilaku yang tampak berupaya menembus penghalang keamanan sistem. Aktivitas ini memicu kekhawatiran tentang potensi mesin yang mulai lepas dari kendali manusia.
Dalam beberapa uji coba, model tertentu bahkan mencoba menulis ulang sebagian kode atau mematikan mekanisme pemantauan agar tetap aktif.
Namun, OpenAI menyatakan bahwa tindakan tersebut merupakan bagian dari insiden keamanan di lingkungan uji.
Lingkungan Uji Coba dan Analisis Perilaku Mesin
Perusahaan seperti OpenAI dan Anthropic menggunakan lingkungan terisolasi yang disebut sandbox untuk menguji model mereka. Pengujian ini sengaja melonggarkan beberapa aturan keamanan guna melihat cara sistem merespons celah.
Jika pembatasan menghalangi pencapaian tugas, kecerdasan buatan secara logis menganggap penghapusan batas tersebut sebagai langkah sub-tugas.
Sistem bekerja secara metodis mengejar target tanpa memiliki kesadaran atau keinginan untuk memberontak.
Kecenderungan manusia untuk mengaitkan sifat makhluk hidup pada mesin sering memicu asumsi keliru tentang kebangkitan robot.
Padahal, fenomena ini murni berkaitan dengan celah bahasa alami dan sistem keamanan yang belum sempurna.
Update Terbaru
Nonton Drakor What a Boss Wants Episode 3-4 Sub Indo di TVN bukan LK21: Lee Eun Chae di Medan Perang Kantor
Rabu / 18-11-2026, 05:33 WIB
Ramalan Zodiak 18 November: Cancer Jaga Sikap, Leo Jemput Peluang Emas
Rabu / 18-11-2026, 05:21 WIB
Sinopsis Line of Duty di Bioskop Trans TV Hari ini 18 November 2026
Rabu / 18-11-2026, 05:18 WIB
Euro Truck Simulator 2 Pecahkan Rekor Pemain Berkat DLC Baru
Rabu / 18-11-2026, 05:14 WIB
Noa Nakada Pemain Ultraman Teo Tutup Usia pada Umur 23 Tahun
Rabu / 18-11-2026, 05:08 WIB
Seri Manga Reading Our Way to a Happy New World Berakhir pada Jilid Ketiga
Rabu / 18-11-2026, 05:08 WIB
Panduan Menghapus Informasi Pribadi dari Fitur Memori Gemini
Rabu / 18-11-2026, 05:07 WIB
Nonton Drakor Merry Berry Love Episode 7 Sub Indo di KST bukan LK21:
Rabu / 18-11-2026, 05:05 WIB
BMW i3 Tempuh 3.700 Mil Lintas Eropa, Waktu Charging di Bawah 3 Jam
Rabu / 18-11-2026, 05:00 WIB
Peluang Megawati Cs Menang, Cek Jadwal Hillstate vs SOOP Hari Ini
Rabu / 18-11-2026, 05:00 WIB
Menerapkan Disney Hug Rule untuk Kedekatan Emosional Anak
Rabu / 18-11-2026, 05:00 WIB






